Comité del jueves. Alguien proyecta la ficha de una startup y arriba, en grande, pone 78.
Nadie pregunta de dónde sale. Se discute si 78 es mucho o poco, si la anterior sacó 81, si el mercado merece más. El número ya está en la sala y ya está trabajando.
La primera pregunta no es si el número acierta. Es qué ha leído la máquina para llegar a él.
Y la segunda, que es la que un fondo debería hacer antes de firmar nada: ¿qué ha leído de lo mío?
Llevo buena parte de este año contestando esas dos preguntas dentro de Trakelt, campo por campo. Esta es la respuesta.
La IA lee una lista, no la base de datos
La forma fácil de construir esto es pasarle al modelo el expediente entero de la startup y que se apañe. Funciona el primer día. También es como acaban dentro de un análisis cosas que son de otro.
Porque el expediente de una startup no guarda solo lo que la startup cuenta de sí misma. Con el tiempo van cayendo ahí cosas de otros: la opinión que la propia IA dio el mes pasado, el hito que acaba de validar un inversor, una nota de un fondo.
Así que en Trakelt el modelo no lee el expediente. Lee una lista de campos de los que se ha decidido, uno a uno, que son declaración de la startup. Problema, solución, mercado, tracción, finanzas, equipo. Un campo nuevo se queda fuera por defecto hasta que alguien decide que es de la startup.
Ese «por defecto» es todo. El fallo posible pasa a ser «la IA todavía no ve un campo nuevo», que se nota. El otro, «la IA de otra firma ve lo que no debe», es de los que no nota nadie.
- Lo que la startup declara en su perfilProblema, solución, mercado, tracción, finanzas, ronda.
- El equipo, en textoNombre, cargo y trayectoria.
- Los informes de analista que marcasLos tuyos, de tu firma, y solo los que incluyes.
- Tus propias notas de due diligence, cuando pides el borrador de un memo
- Lo que la startup contestó en privado a otro fondo
- Los nombres de clientes y financiadores que no se pueden citarAl modelo le llega «cadena hotelera de 40 hoteles», no el nombre.
- Las fotos del equipoUn dato personal de un tercero que no dice nada de la compañía.
- La opinión anterior de la propia IA
- Cualquier campo nuevo, hasta que alguien decide que es de la startup
Lo que no se sabe, no se inventa
La otra mitad del problema no es lo que entra. Es lo que hace el sistema cuando falta algo. Tres decisiones:
1- Sin análisis de IA, no hay nota de IA. Durante un tiempo, a una startup sin análisis se le ponía un 50 fijo y ese 50 se mezclaba con el criterio de los analistas como si la máquina hubiera dicho algo. Hoy la nota sale como no disponible y el peso de la IA baja a cero. La decisión se queda entera en manos de personas.
2- Los analistas que no han hablado no son un cero. Este era peor. Sin ningún informe de analista, el consenso se calculaba igual, contando su silencio como un cero: una startup con un 76 salía con 0,30 × 76 = 22,8 y un «No invertir» formal. Una recomendación construida sobre gente que nunca opinó. Hoy sencillamente no se calcula, y la pantalla dice por qué.
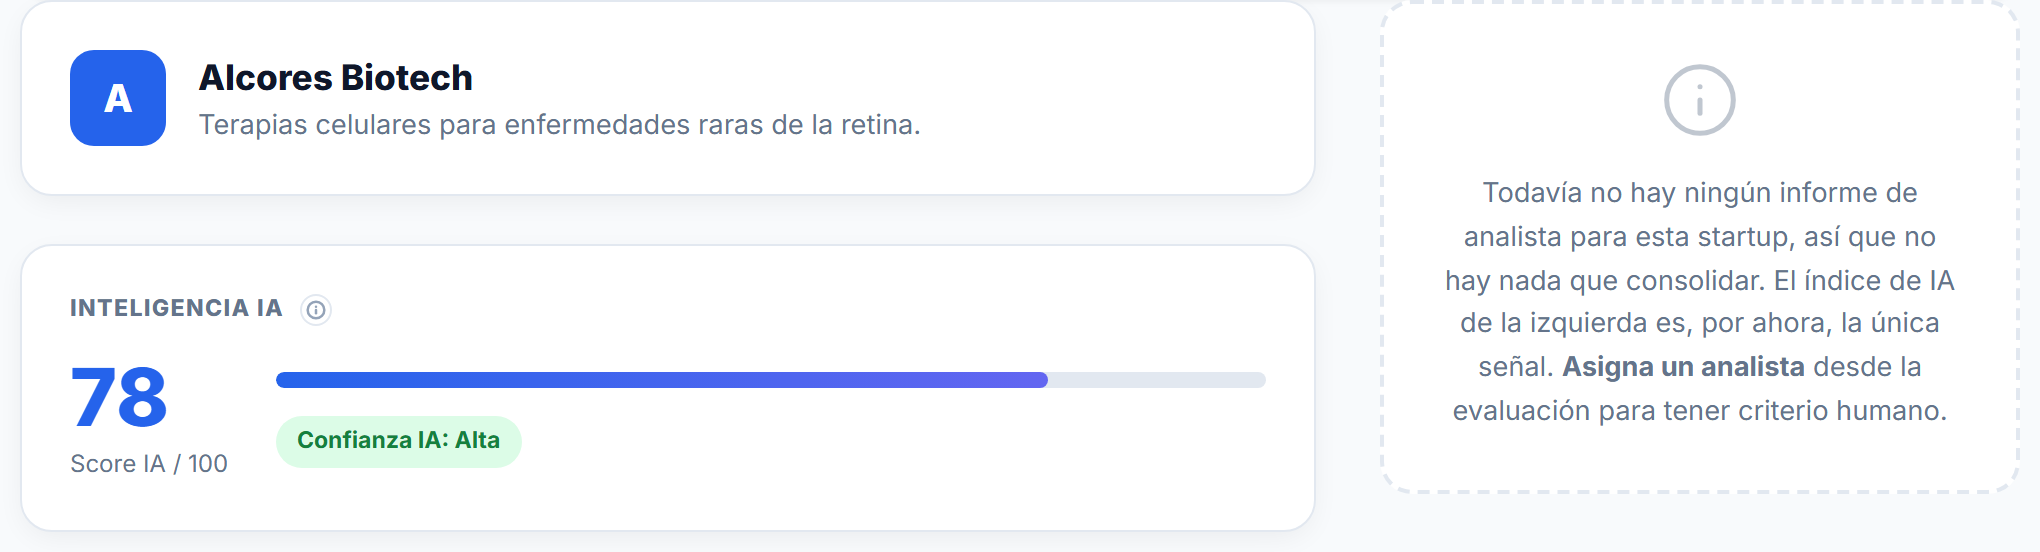
3- Un apartado sin materia prima se queda vacío. Cuando le pides a la IA que redacte la ficha de análisis, escribe solo los apartados para los que hay datos. Prefiero un hueco reconocible a un párrafo que nadie va a poder desmentir. Y nunca pisa lo que ya ha escrito una persona. Sustituir en silencio el análisis de alguien sería la peor forma de ayudar.
Cuánto pesa, y quién lo decide
El peso de la IA en la recomendación consolidada lo pones tú, con un deslizador. Va de 0 a 50. No a 100. La máquina no puede ganarle nunca la votación a tus analistas, y ese tope no está solo en el deslizador: el servidor también lo aplica.
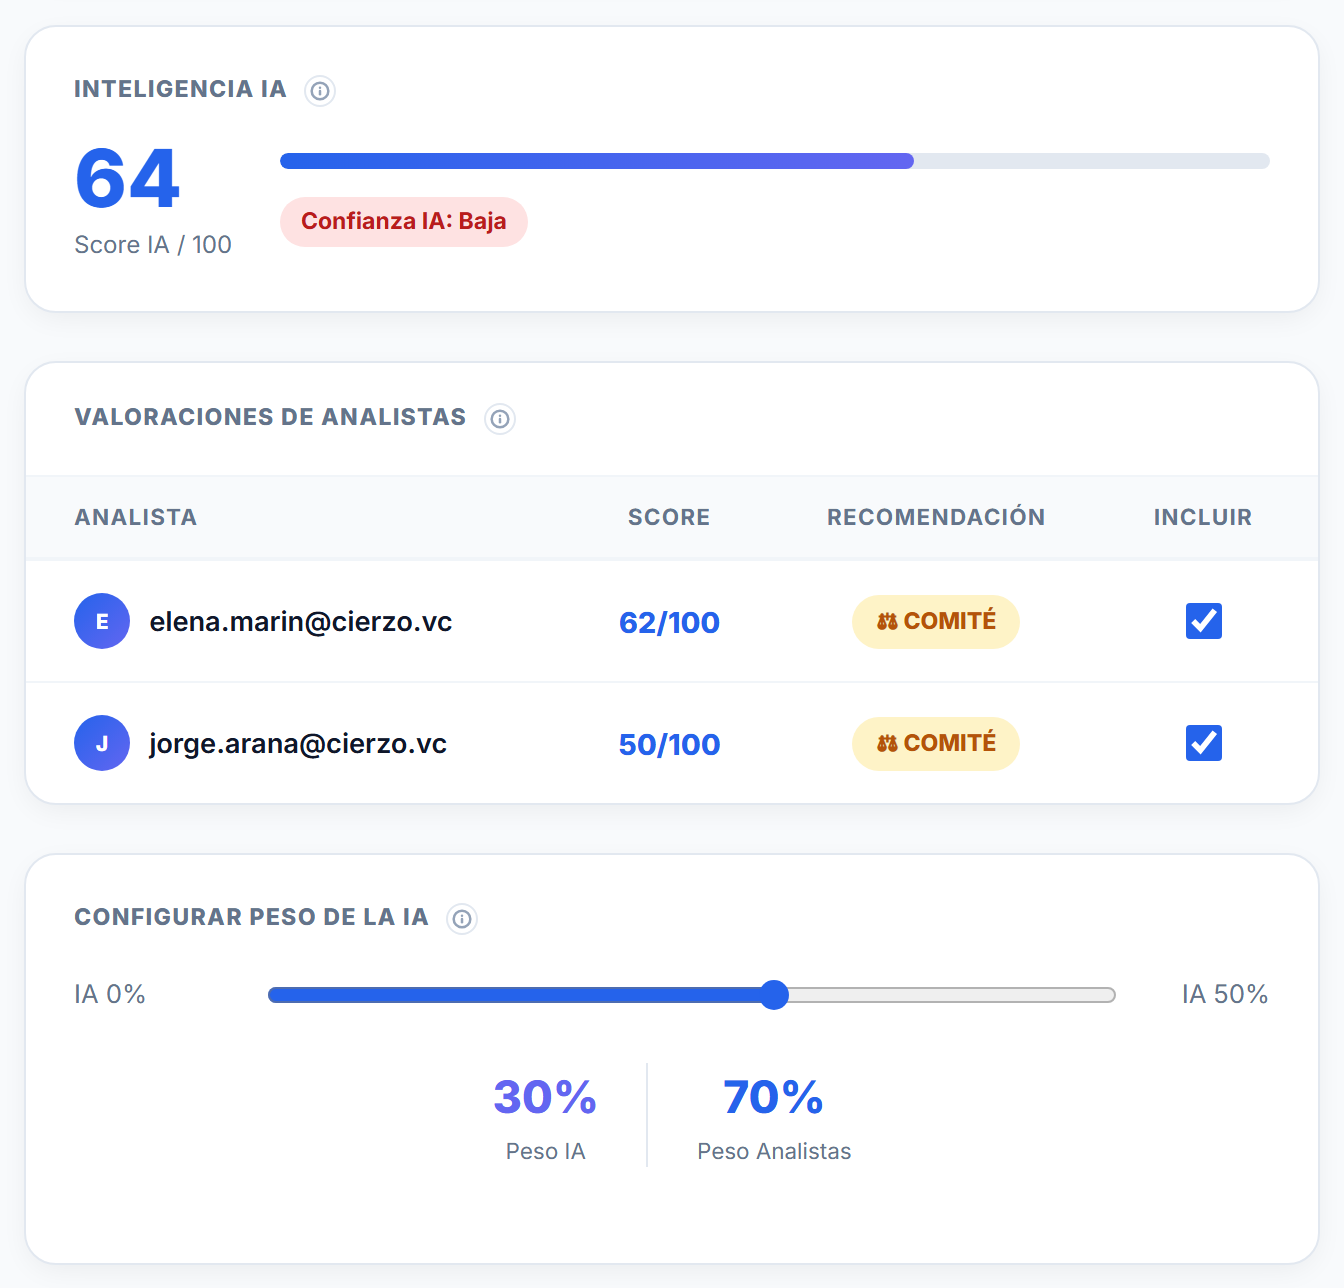
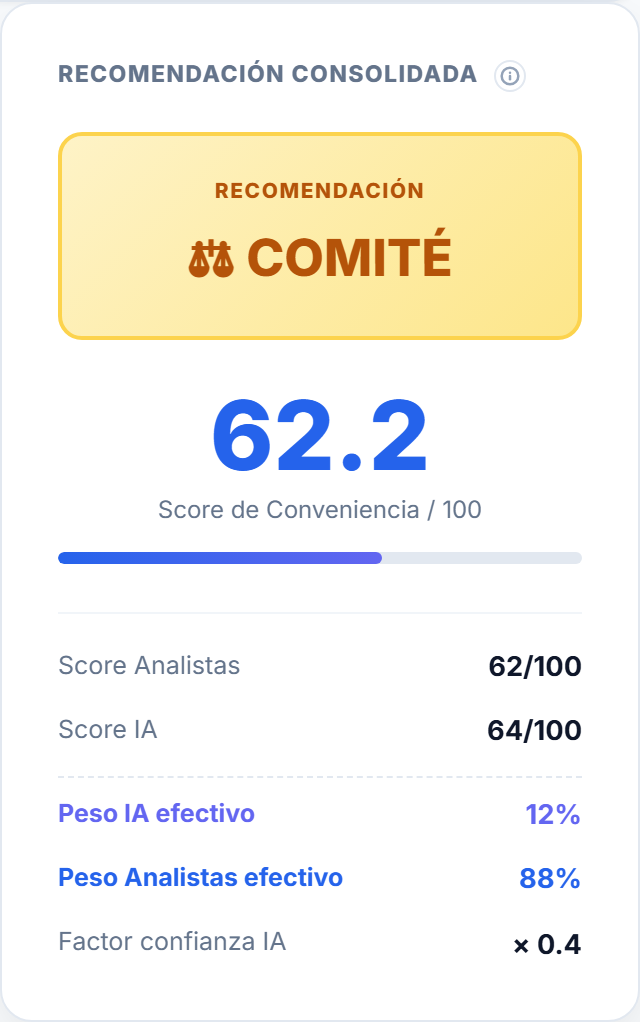
Y ese peso se corrige otra vez según lo fiable que sea el análisis. Cada análisis sale con un nivel de confianza, que baja cuando faltan datos clave para la fase de la startup. Con confianza alta el peso se queda entero. Con media, en el 70 %. Con baja, en el 40 %.
Así que un fondo que le da a la IA un 30 %, delante de una startup con el perfil a medias, le está dando en realidad un 12 %. El otro 88 % va a sus analistas, sin que nadie tenga que acordarse de desconfiar.
Lo que vuelve tampoco se da por bueno
Hay una tercera frontera que se suele olvidar: la de vuelta. Lo que devuelve un modelo es texto escrito por una máquina, y lo tratamos como una entrada de la que no hay que fiarse.
Cuando la IA dice que una acción subiría 25 puntos la «tracción», esa etiqueta y ese número se comprueban antes de guardarse. Si la dimensión no es una de las cinco reales, o la cifra no es un número entre 0 y 100, se retiran las dos y la tarjeta cae a texto llano. Una respuesta mala se degrada a algo sobrio. No imprime una etiqueta inventada.
Por qué la decisión no se automatiza
Porque consolidar exige dos partes. Solo con el índice de la IA, la pantalla no pinta una recomendación consolidada: el índice está ahí, solo y bien rotulado, y llamarlo «consenso» sería decir que hay acuerdo entre uno.
Y porque lo que viene después no es un cálculo. En el comité votan personas, con su nombre y su porqué. Y en el post-mortem de la primera entrega al motor se le audita como a todos: hay una regla que salta cuando puntuó alto a una compañía y la compañía fracasó.
La IA redacta y propone. Vota una persona, y firma.
Lo que esto no resuelve
La IA lee lo que la startup declara. Si el perfil está mal, el análisis hereda el error con buena letra. Para eso está el nivel de confianza, y para eso sigue estando la due diligence.
Y lo que está en esa lista sí sale de la plataforma para llegar al modelo que redacta el análisis. Justo por eso la lista es corta, y justo por eso es una lista.
Con esta entrega se cierra la serie. Cinco piezas sobre la misma idea: el criterio de un fondo no es lo que dice de sí mismo, es lo que puede enseñar.
Si en tu fondo ya se usa IA para analizar operaciones: ¿sabrías decir, campo por campo, qué lee?
Seguimos construyendo.
La serie: El criterio del fondo
¿Quieres ver qué leería la IA de tu dealflow?
Solicita acceso, evalúa una startup con tus analistas y mira cuánto pesa de verdad la IA en el resultado.
🚀 Solicitar invitación